一、引言:为什么大数据需要"服务化"
传统大数据平台的核心命题是"把数据处理得又快又对"——采集、存储、计算、分析构成了一条以技术和数据为中心的流水线。当数据消费者从少数分析师扩展为企业内外部众多业务系统时,问题就变了:业务方并不关心底层跑了多少个Spark任务,他们关心的是"我能不能按需拿到可信的数据结果"。大数据服务化技术架构正是为回应这一转变而提出的:它旨在将大数据处理和分析能力封装为标准化、可复用、可治理的数据处理服务,让数据能力从"项目交付"走向"服务供给"。
二、总体架构分层
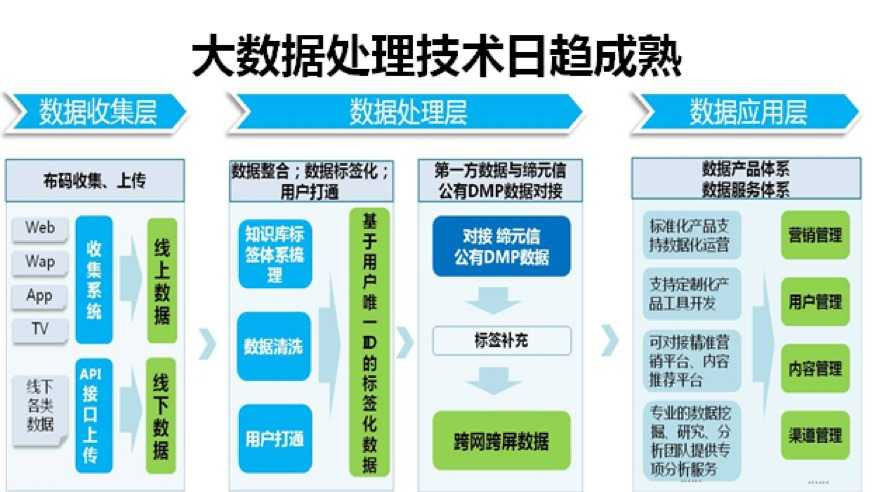
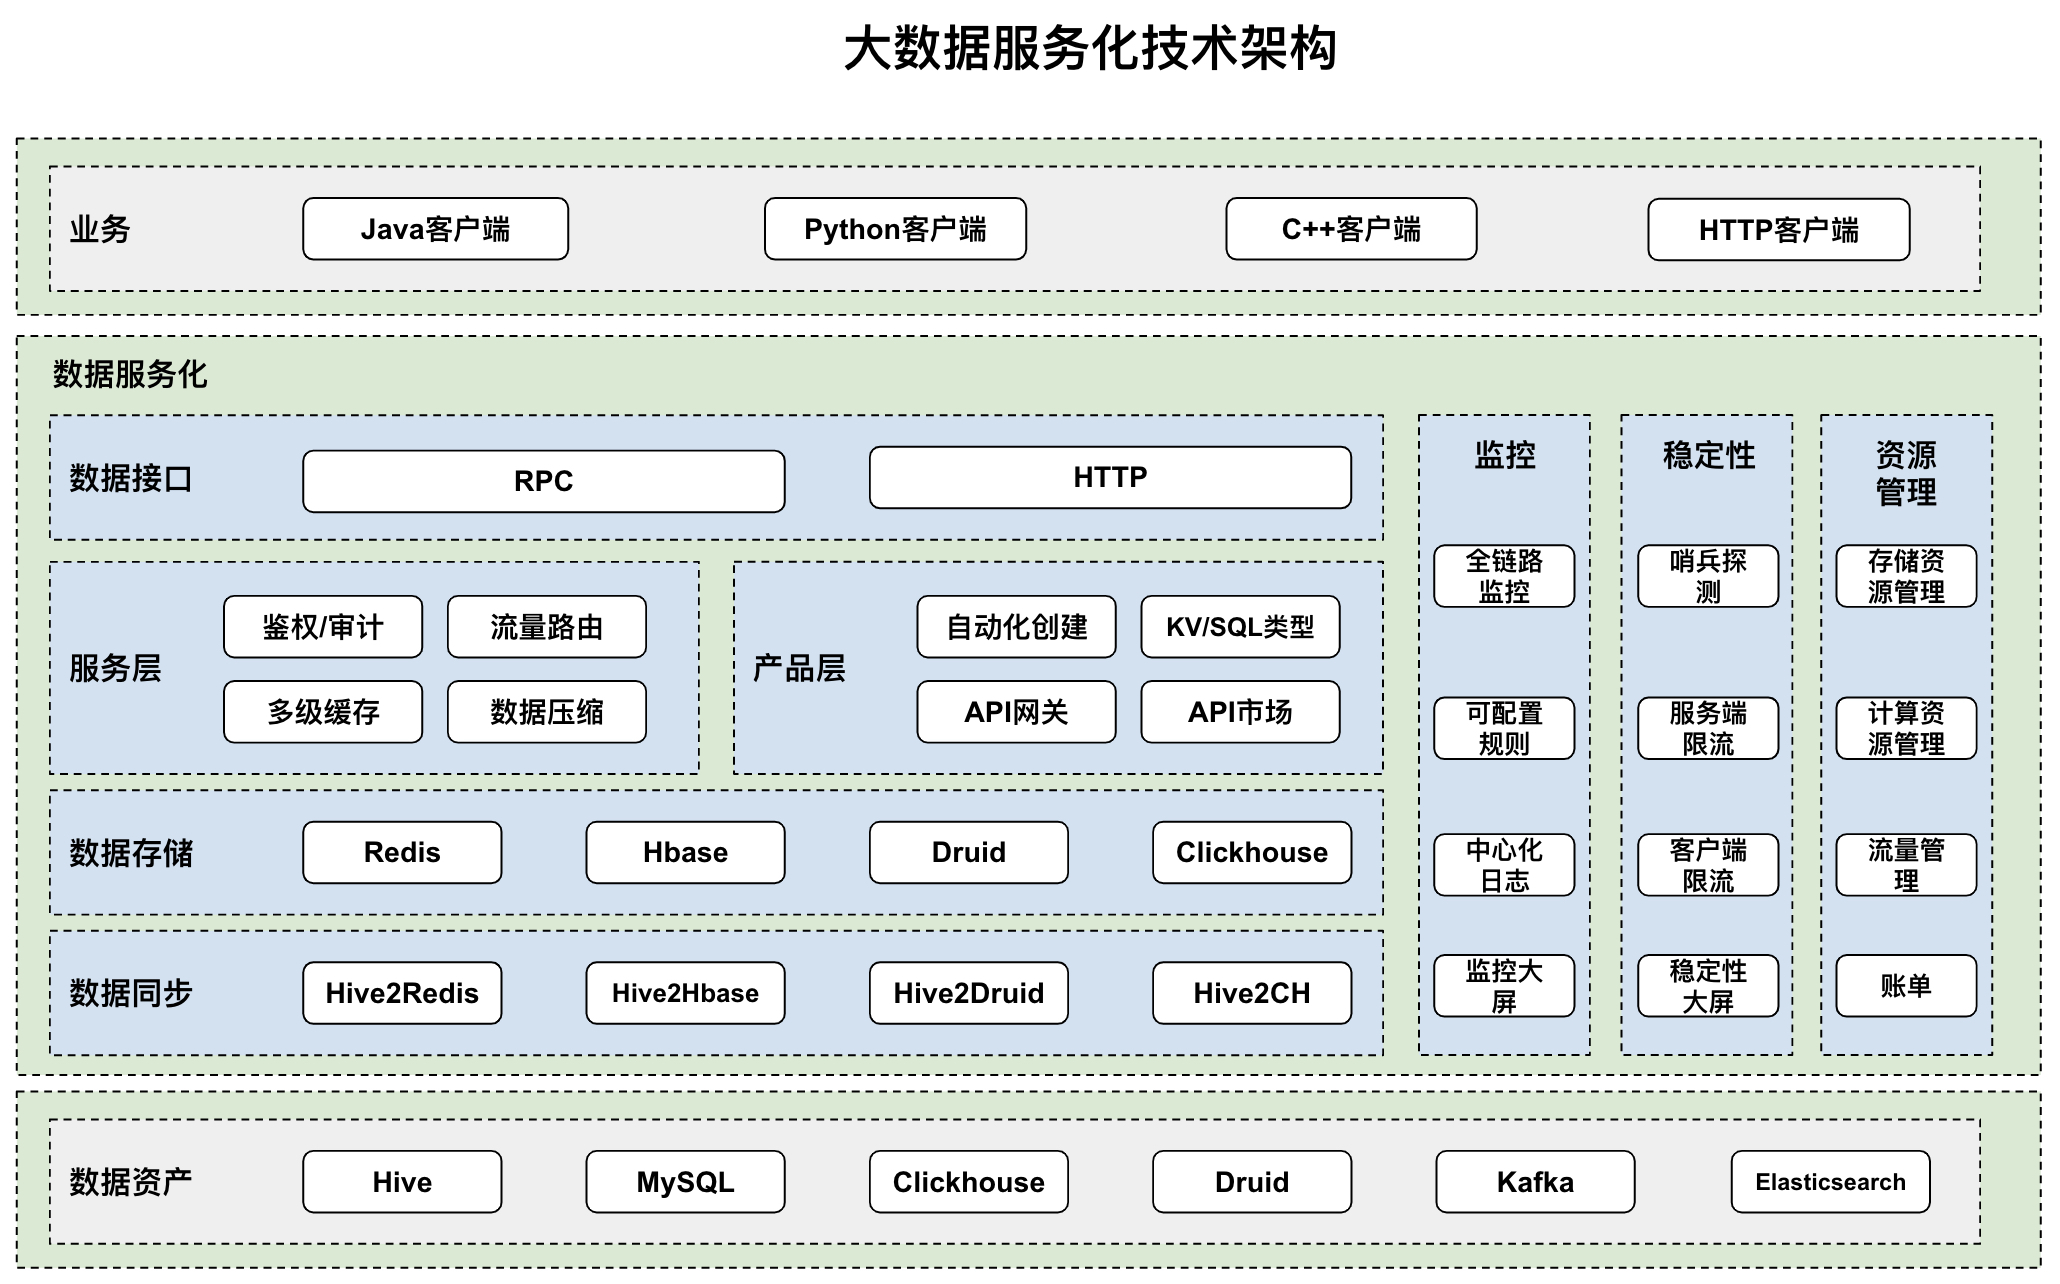
一个典型的大数据服务化技术架构可以划分为五层:
1. 数据源层:关系型数据库、日志、埋点、IoT设备、第三方数据等,构成服务的原始输入。
2. 数据存储与计算层:以Hadoop/Spark/Flink、数据湖仓(Iceberg、Hudi、Delta Lake)、MPP数据库为底座,承担批量处理与实时计算。
3. 数据处理服务层(核心):将清洗、加工、聚合、建模等处理逻辑封装为可复用的服务单元,如数据清洗服务、指标计算服务、标签加工服务、特征工程服务等,形式可以是API、任务模板或调度组件。
4. 数据服务编排与治理层:负责服务注册、编排、版本管理、服务目录、权限控制、质量监控与SLA保障,是"服务化"得以成立的制度与技术基础设施。
5. 数据消费层:BI报表、数据API网关、指标平台、AI训练平台、业务系统等,以自助方式订阅和调用服务。
三、核心设计原则
服务解耦。每条数据处理能力作为独立服务对外暴露,业务方不必感知底层引擎和数据分区细节,技术栈的演进不会传导为业务改造。
标准化契约。每个服务需明确定义输入输出Schema、调用方式、质量等级和SLA,契约成为服务提供方与消费方之间的共同语言。
可复用优先。指标体系、标签体系、特征体系以服务形式沉淀,避免同类加工逻辑在不同项目中重复建设。
可观测与可治理。服务的调用链、耗时、数据质量、血缘关系全程可追踪,服务质量可度量、可追责。
四、关键技术实现
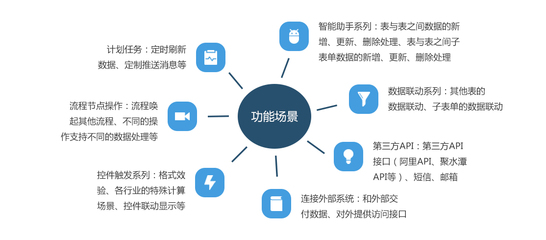
处理逻辑服务化:通过参数化任务模板和配置化算子,将ETL/ELT逻辑抽象为"输入Dataset + 处理算子 + 输出Dataset"的声明式服务。例如指标服务接收维度、度量、时间范围参数,内部自动生成并调度计算任务。
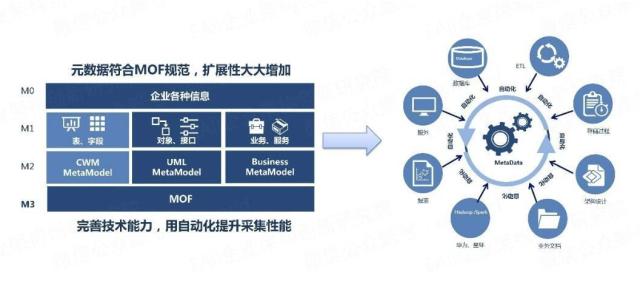
统一元数据与数据虚拟化:以元数据中心串联数据资产、服务目录和质量规则,配合数据虚拟化层屏蔽异构存储差异,使服务消费方以一致方式访问湖、仓、库中的数据。
服务编排引擎:基于DAG编排多个处理服务形成数据加工流水线,支持依赖管理、失败重试和增量触发;面向实时场景则结合Flink流式计算实现状态的连续加工服务。
API网关与访问控制:数据API经由统一网关暴露,实现鉴权、限流、审计和计量,让数据服务像微服务一样被消费和运营。
质量与SLA保障:在服务契约中嵌入数据质量规则(完整性、唯一性、及时性),质量不达标时阻断下游消费或触发告警,确保"服务"而非"结果"本身是可承诺的。
五、典型应用场景
- 指标服务:一次建模、多处复用,业务系统通过指标API按维度组合实时查询一致口径的指标。
- 标签与画像服务:将用户标签加工封装为服务,营销系统按人群规则调用生成人群包。
- 特征服务:为模型训练和在线推理提供一致的离线/在线特征加工能力,降低特征重复开发的成本。
- 数据共享服务:在安全合规前提下,以沙箱API或受限数据集服务方式向外部合作方供给数据。
六、落地挑战与应对
实践中,服务化架构面临三类突出挑战:一是服务粒度难以把握,过细则治理成本高,过粗则复用性差,宜以"业务可理解的最小发布单元"为切分参考;二是跨服务的数据一致性,需要依赖血缘体系和端到端对账机制;三是服务目录容易沦为文档仓库,必须把注册、订阅、调用打通为线上闭环,用真实调用量驱动服务持续优化。服务多级依赖导致的"雪花式"链路需要强的血缘追溯能力支撑故障定位。
七、
大数据服务化的本质,是把数据平台的能力从"做项目"转为"做产品",使数据处理与分析能力成为可发现、可订阅、可计量、可问责的公共服务。架构建设的重点因此不止于技术组件,更在于契约设计、目录运营与治理机制——让数据处理真正成为被业务方持续消费的数据服务。